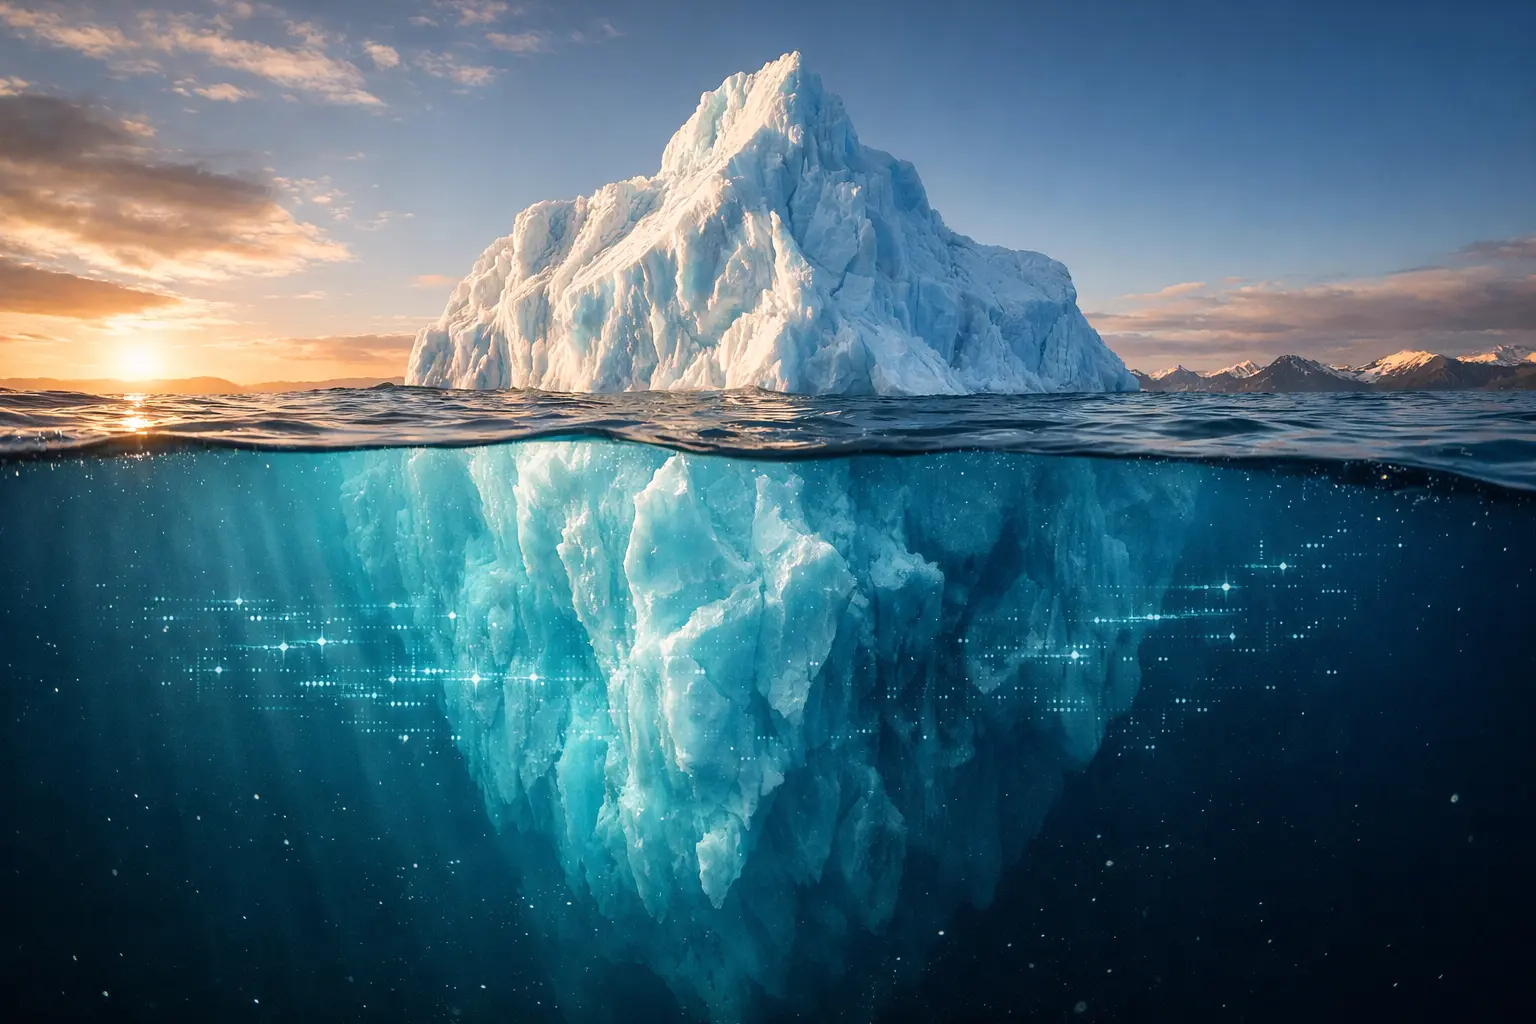
Az internet világát talán legplasztikusabban egy hatalmas jéghegyhez tudnánk hasonlítani. Amit mindannyian ismerünk és nap mint nap használunk – a Google keresőbe beírt kifejezések eredményei, a közösségi média felületek, a híroldalak – csupán a víz feletti csúcs. Ez a felszíni, vagy látható web, ami valójában az egész internet mindössze néhány százalékát teszi ki. A jéghegy tömege viszont a víz alatt húzódik: ez a deep web, ahol a legtöbb adat található, de ezeket a tartalmakat hagyományos keresőmotorok egyszerűen nem érik el. A kettő közötti különbség lényegében abban rejlik, hogy míg a látható web tartalmait bárki könnyen megtalálhatja egy keresőmotor segítségével, addig a deep web oldalai jelszavakkal védettek, dinamikusan generálódnak, vagy egyszerűen nem indexelhetők a hagyományos módszerekkel. Fontos hangsúlyozni, hogy a deep web túlnyomó többsége teljesen legális és mindennapi használatra szolgál, gondoljunk csak az email fiókjainkra, a banki felületeinkre vagy a munkahelyi belső rendszerekre. De nézzük meg részletesen, hogyan működik ez a két világ, miben különböznek egymástól, és milyen változásokat hoznak az új technológiai fejlesztések.
Tartalomjegyzék
A látható web: ami a keresőkben megjelenik
Amikor bármelyik keresőmotort használjuk – legyen az Google, Bing vagy bármi más – valójában csak az internet egy apró szeletében kutatunk. A látható web tartalmazza az összes nyilvánosan elérhető weboldalt, blogot, híroldalakat és közösségi média platformot, amelyeket a keresőmotorok robotjai képesek bejárni és indexelni. Ezek a robotok, amelyeket crawlereknek vagy spidereknek is nevezünk, automatikusan végigsétálnak a weboldalak között, követik a linkeket, és folyamatosan frissítik a keresőmotorok adatbázisait. Amikor egy YouTube-videót találunk a Google találatok között, vagy amikor egy Instagram-poszt megjelenik a keresési eredményekben, mind a látható web működését látjuk munkában. A statisztikák szerint ez a látható rész az egész internet mindössze négy-tíz százalékát teszi ki, ami körülbelül négy és fél milliárd indexelhető oldalt jelent. Persze ez is hatalmas szám, de eltörpül a teljes internethez képest. Az elmúlt években különösen érdekes változások történtek ezen a területen. A mesterséges intelligencia térnyerésével egyre több dinamikusan generált tartalom jelenik meg, amelyek többsége még mindig indexelhető marad, de a complexitásuk miatt néha a keresőmotoroknak is nehézséget okoz a pontos besorolásuk. A decentralizált platformok megjelenése, mint például a blockchain alapú weboldalak, szintén érdekes kérdéseket vet fel: egyesek ezek közül lassan átcsúsznak a látható web kategóriába, ahogy javul a kereshetőségük. Ugyanakkor az adatvédelmi törekvések, amelyeket a nagy technológiai cégek is egyre komolyabban vesznek, néha pont az ellenkező hatást érik el – egyes nyilvános tartalmak egyszerűen eltűnnek a keresési eredményekből, mert a tulajdonosok korlátozzák a crawlerek hozzáférését.
Miért ilyen kicsi a látható web?
Sokan meglepődnek, amikor először hallják, hogy az általuk ismert internet csak egy pici szelete a teljes világnak. Ennek oka elsősorban technikai jellegű: a keresőmotorok crawlerei csak azokat az oldalakat képesek elérni, amelyek nyíltan linkelhetők, szabványos domainnel rendelkeznek – mint például a megszokott com, org vagy hu végződések – és amelyek nem blokkolják aktívan ezeket a robotokat. Rengeteg weboldal szándékosan ki van zárva az indexálásból, például a robots.txt fájl használatával, amely közli a crawlerekkel, hogy mely részeket ne látogassák meg. Emellett vannak olyan tartalmak is, amelyek technikai természetüknél fogva nem érhetők el: például ha egy oldal tartalma csak JavaScript futtatása után töltődik be, vagy ha egy adatbázis lekérdezés eredményeként jön létre, akkor a hagyományos crawlerek egyszerűen nem tudják feldolgozni. Az adatok túltelítettsége is egyre nagyobb problémát jelent a látható weben. Akkora mennyiségű tartalom keletkezik minden nap, hogy egyre nehezebbé válik a valóban releváns információk megtalálása. Emiatt egyre többen fordulnak speciális keresőeszközök vagy mesterséges intelligencia alapú asszisztensek felé, amelyek képesek a hatalmas adatmennyiségből kiszűrni a lényeget. A látható web legnagyobb előnye egyértelműen a hozzáférhetőség: bárki, bármilyen eszközről, néhány kattintással elérhet szinte bármilyen információt. Ezzel szemben a legnagyobb hátránya, hogy mivel mindenki számára nyitott, rengeteg spam, félrevezető és egyenesen hamis tartalom is megjelenik rajta.
A deep web: ahol az igazi adattömeg van
A deep web az internet kilencven-kilencvenhat százalékát alkotja, és olyan tartalmakat foglal magában, amelyeket a keresőmotorok egyszerűen nem tudnak indexelni. Fontos tisztázni rögtön az elején: a deep web nem azonos a dark webtel, és egyáltalán nem bűnöző vagy illegális tevékenységek színhelye. Éppen ellenkezőleg, mindennapi életünk jelentős része itt zajlik. Ide tartoznak például az összes bejelentkezés-védett oldal: az email fiókunk, a banki felületek, a felhőalapú tárolóink, mint a Google Drive vagy a Dropbox. Ezek mind a deep web részei, mert bár mi szabadon hozzáférünk hozzájuk, a keresőmotorok crawlerei nem képesek belépni és indexelni őket. Szintén ide tartoznak a különböző adatbázisok: akadémiai kutatások archívumai, orvosi nyilvántartások, kormányzati adatbázisok, amelyekhez csak speciális jogosultsággal lehet hozzáférni. Amikor például egy önkormányzat ingatlanadó-nyilvántartásában keresünk egy konkrét cím alapján, akkor egy deep webes adatbázist használunk – ezt az információt soha nem találnánk meg Google kereséssel. A deep webhez tartoznak még a dinamikusan generált tartalmak is: például amikor egy weboldalon kitöltünk egy űrlapot, és az eredmény csak a lekérdezésünk után jelenik meg, azt a tartalmat a crawlerek nem érik el, mert nem tudnak interaktívan részt venni az űrlap kitöltésében. A vállalatok belső hálózatai, az intranetek, az oktatási platformok zárt területei szintén mind ide tartoznak.
Hogyan változtatja meg az IoT a deep webet?
Az utóbbi években a dolgok internetének, vagyis az IoT rendszerek robbanásszerű terjedése teljesen új dimenziót adott a deep webnek. Mára több tízmilliárd csatlakoztatott eszköz generál folyamatosan adatokat: okosotthon rendszerek, viselhető eszközök, ipari szenzorok, intelligens városok infrastruktúrája. Ezek az adatok szinte teljes egészében a deep webben tárolódnak, különböző adatbázisokban, amelyekhez csak autorizált eszközök vagy felhasználók férhetnek hozzá. Gondoljunk csak arra, amikor az okostelefonunkkal megnézzük a biztonsági kamera felvételeit otthonról: ezek a videók egy privát szervereken vagy felhőszolgáltatásban vannak, nem pedig a nyilvános interneten. Ugyanez igaz az okos-hűtőnk adataira, a fitneszórák által mért egészségügyi paramétereinkre, vagy az autónk diagnosztikai adataira is. Ezek mind a deep web részei, és ezt a réteget évről évre exponenciálisan növelik. A helyzet még érdekesebbé válik az edge computing térnyerésével: ez azt jelenti, hogy egyre több adat feldolgozása nem központi szervereken, hanem helyben, az eszközökön magukon vagy közeli kis szervereken történik. Ez csökkenti ugyan a felhőbe feltöltött adatok mennyiségét, de növeli a biztonságot és a privátságot, mivel az érzékeny információk nem hagyják el a helyi hálózatot. Ugyanakkor ez új kihívásokat is jelent: ha ezek az edge eszközök nem megfelelően védettek, akkor komoly biztonsági réseket kínálhatnak a támadóknak.
Miben különbözik a két világ a gyakorlatban?
Ha konkrét példákon keresztül nézzük, sokkal érthetőbbé válik a különbség. Amikor a Google-be beírjuk, hogy „legjobb étterem Budapesten”, és megkapjuk az eredményeket, akkor a látható webet használjuk – ezek az éttermek honlapjai, értékelő oldalak és blogbejegyzések mind indexeltek és nyilvánosan elérhetők. Amikor viszont bejelentkezünk a banki alkalmazásunkba és megnézzük a számlaegyenlegünket, akkor a deep webet használjuk – ezek az információk védettek, személyre szabottak, és semmilyen keresőmotor nem érheti el őket. Egy másik példa: ha megnézünk egy YouTube-videót, az a látható weben van, mert a Google indexálja és megjeleníti a keresési eredmények között. De ha ugyanezen a YouTube-csatornán van egy nem listázott videó, amelynek a linkjét csak bizonyos emberek kapták meg, az már inkább a deep web felé tolódik, mivel nem kereshető és nem indexelhető. Az egyetemi könyvtárak digitális archívumai szintén kiváló példák: sok akadémiai publikáció csak akkor érhető el, ha diák vagy kutató vagy és rendelkezel az intézmény hozzáférési jogosultságaival. Ezek a tartalmak léteznek a weben, de a felszíni keresőmotorok számára láthatatlanok maradnak. A munkahelyi intranet rendszerek is ebbe a kategóriába tartoznak: a vállalat belső dokumentumai, projektmenedzsment eszközei, kommunikációs felületei mind a deep webben vannak, és csak a cég alkalmazottai férhetnek hozzájuk VPN-en vagy belső hálózaton keresztül.
A mesterséges intelligencia hatása mindkét világra
Az AI technológiák elterjedése alapjaiban változtatja meg mind a látható, mind a deep web működését. A látható weben egyre több automatikusan generált tartalom jelenik meg: chatbotok által írt cikkek, AI által készített képek és videók, algoritmusok által összeállított ajánlások. Ezek a tartalmak még mindig indexelhetők, de megváltoztatják a keresési eredmények természetét. Egyre nehezebb megkülönböztetni az emberi és a gépi tartalmakat, ami új kihívásokat jelent mind a felhasználók, mind a keresőmotorok számára. A keresőmotorok maguk is egyre inkább mesterséges intelligenciát használnak: nem csupán kulcsszavakat keresnek, hanem megértik a kontextust, a felhasználó szándékát, és ennek megfelelően állítják össze az eredményeket. A deep web esetében az AI egy teljesen más szerepet tölt be. Automatizált workflow rendszerek képesek különböző deep webes adatbázisokat összekötni, lekérdezni és feldolgozni anélkül, hogy ezek a tartalmak indexelhetővé válnának. Például egy vállalat használhat olyan AI-alapú rendszert, amely összegyűjti az adatokat különböző belső forrásokból – CRM rendszer, pénzügyi adatbázis, projekt management eszköz – és automatikusan elkészít belőle jelentéseket. Ezek az adatok soha nem kerülnek ki a deep webből, de az AI képes velük dolgozni és értéket teremteni belőlük. Érdekes fejlemény, hogy egyes új generációs keresők már képesek bizonyos deep webes tartalmakat is elérni: nem teljes indexálással, hanem speciális lekérdezésekkel és API-kon keresztül, ami fokozatosan elmossa a határt a két világ között.
Biztonsági kérdések és kockázatok
Mindkét világnak megvannak a saját biztonsági kihívásai, bár ezek jellege alapvetően különbözik. A látható weben a legnagyobb veszély a nyilvánosság maga: mivel bárki bármit publikálhat, rengeteg a félrevezető információ, az adathalász próbálkozás és a rosszindulatú tartalom. A felhasználóknak folyamatosan ébernek kell lenniük, hogy ne kattintsanak gyanús linkekre, ne osszanak meg érzékeny információkat nyilvános felületeken, és kritikusan értékeljék a talált tartalmakat. A keresőmotorok ugyan próbálnak szűrni és figyelmeztetni a veszélyes oldalakra, de ez a védelem sosem lehet tökéletes. A deep web biztonsági kihívásai inkább az adatvédelemről és a hozzáférés-szabályozásról szólnak. Mivel itt érzékeny személyes adatok, pénzügyi információk és bizalmas dokumentumok találhatók, egy sikeres támadás sokkal súlyosabb következményekkel járhat. Az elmúlt években több nagy adatszivárgás is történt deep webes rendszerekből, amikor hackerek hozzáfértek banki adatbázisokhoz, egészségügyi nyilvántartásokhoz vagy kormányzati rendszerekhez. Ezek az incidensek milliókat érintettek és mutatják, hogy mennyire fontos a megfelelő védelem. A jelszóvédelem itt elengedhetetlen, de önmagában már nem elég: többfaktoros azonosítás, titkosítás, rendszeres biztonsági frissítések és nulla bizalmi modell bevezetése szükséges. Ez utóbbi azt jelenti, hogy alapértelmezetten semmilyen kapcsolat nem tekinthető megbízhatónak, és minden hozzáférési kérelmet külön ellenőrizni kell. Fontos megjegyezni, hogy a deep web nem azonos a dark webbel: az utóbbi speciális böngészőkkel, mint a Tor, érhető el, és szándékosan rejtett szolgáltatásokat tartalmaz, amelyek között valóban találhatók illegális tartalmak is. A deep web viszont a mindennapjaink része és alapvetően legális funkciókat lát el.
A web3 és a decentralizáció új korszaka
Az utóbbi években egyre többet hallani a web3 fogalmáról, amely egy alapvetően új megközelítést képvisel az internet működésében. A blockchain technológia és a decentralizált tárolási megoldások, mint például az IPFS, érdekes módon hidat képeznek a látható és a deep web között. Ezekben a rendszerekben a tartalmak nem központi szervereken, hanem elosztott hálózatokban tárolódnak, ahol minden résztvevő hozzájárul a tárolási kapacitáshoz. Ez azt jelenti, hogy egy tartalom létezhet és elérhető lehet anélkül, hogy egy hagyományos szerveren, hagyományos domain alatt lenne megtalálható. Egyes ilyen tartalmak indexelhetők és így a látható web részévé válhatnak, míg mások privát módon, csak kriptográfiai kulcsok birtokában érhetők el, így inkább a deep web kategóriájába tartoznak. A web3 ígérete szerint a felhasználók nagyobb kontrollt kapnak saját adataik felett: nem egy nagy technológiai cég tárolja az információinkat, hanem mi magunk irányítjuk, hogy kinek és mikor adjuk hozzáférést. Ez a változás potenciálisan átalakíthatja mind a látható, mind a deep web működését. A gyakorlatban azonban még mindig a kezdeti fázisban vagyunk: a decentralizált alkalmazások használata bonyolultabb, a hálózat sebessége gyakran lassabb, és a felhasználói élmény még nem versenyképes a hagyományos webes szolgáltatásokkal. Ugyanakkor a fejlődés folyamatos, és néhány éven belül ezek a technológiák mainstream használatba kerülhetnek. Különösen érdekes, hogy a decentralizált identitás-menedzsment hogyan változtathatja meg a hitelesítés és hozzáférés-szabályozás jelenlegi rendszerét: nem kellene többé tucatnyi jelszót megjegyezni, hanem egyetlen kriptográfiai identitással igazolhatnánk magunkat különböző szolgáltatásokban, miközben teljes kontrollt tartanánk az adataink felett.
Az automatizáció és a workflow rendszerek szerepe
A modern üzleti folyamatok egyre inkább támaszkodnak olyan automatizált rendszerekre, amelyek képesek adatokat mozgatni a deep web különböző részei között. Ezek a workflow automatizációs platformok lehetővé teszik, hogy különböző szolgáltatásokat kössünk össze anélkül, hogy programozási tudásra lenne szükségünk. Például beállíthatunk egy olyan automatizációt, amely minden alkalommal, amikor egy új ügyfél regisztrál a weboldalunkon (látható web), automatikusan létrehoz egy bejegyzést a CRM rendszerünkben (deep web), értesíti az értékesítési csapatot emailben (deep web), és elindít egy üdvözlő email sorozatot. Mindez emberi beavatkozás nélkül, automatikusan történik. Ezek a rendszerek API-kon keresztül kommunikálnak a különböző szolgáltatásokkal, és így képesek elérni olyan deep webes adatokat, amelyekhez normál esetben csak bejelentkezés után férne hozzá egy felhasználó. Az automatizáció nemcsak hatékonyságot jelent, hanem új biztonsági kérdéseket is felvet: ha egy automatizációs platform hozzáfér több különböző rendszerhez, akkor egy kompromittálás esetén az összes kapcsolódó szolgáltatás veszélybe kerülhet. Ezért különösen fontos, hogy ezek a platformok megfelelő biztonsági intézkedéseket alkalmazzanak: titkosított adattárolás, biztonságos token kezelés, audit logok és rendszeres biztonsági auditok. A jövőben várhatóan egyre intelligensebbé válnak ezek a rendszerek: mesterséges intelligencia segítségével nem csak egyszerű ha-akkor szabályokat hajtanak végre, hanem képesek lesznek tanulni a felhasználói viselkedésből és proaktívan javasolni vagy végrehajtani automatizációkat.
Fenntarthatóság és energia kérdések
Amiről ritkábban beszélünk, de egyre fontosabb téma, hogy az internet működése hatalmas energiaigénnyel jár. A deep web különösen problematikus ebből a szempontból, mivel az adatközpontok, amelyek a banki rendszereket, felhőszolgáltatásokat és nagyvállalati adatbázisokat működtetik, folyamatosan üzemelnek, hűtést igényelnek, és jelentős mennyiségű áramot fogyasztanak. Egy közepes méretű adatközpont energiafogyasztása megegyezhet egy kisváros teljes fogyasztásával. A technológiai ipar egyre nagyobb figyelmet fordít erre a problémára: sok nagy szolgáltató arra törekszik, hogy adatközpontjait megújuló energiaforrásokból táplálja, vagy legalábbis karbonsemlegessé tegye a működését. Az edge computing térnyerése ebből a szempontból is előnyös lehet, mivel a helyi adatfeldolgozás csökkenti a nagy távolságokra történő adatátvitel és a központi szerverek terhelését. Ugyanakkor az IoT eszközök millióinak energiafogyasztása is összeadódik, így a teljes kép összetett. A fenntarthatóság kérdése nem csak környezetvédelmi szempontból fontos, hanem gazdasági szempontból is: az energiaköltségek jelentős részét teszik ki egy adatközpont működési költségének. Ezért az energiahatékony hardverek, az intelligens hűtési megoldások és az optimalizált szoftverek fejlesztése nemcsak erkölcsi imperatívusz, hanem üzleti érdek is. A látható web esetében is vannak fenntarthatósági kérdések: a felesleges letöltések, a rosszul optimalizált weboldalak, amelyek túl sok adatot töltenek le, vagy a túlzottan nagy felbontású képek mind járulnak hozzá a szükségtelen energiafelhasználáshoz.
Hogyan változik a keresés jövőbeli modellje?
A hagyományos keresőmotorok működése az elmúlt huszonöt évben alapvetően ugyanaz volt: crawlerek bejárják a webet, indexelik a tartalmakat, majd a felhasználó egy kulcsszó alapján keres, és kap egy listát releváns linkekről. Ez a modell azonban gyorsan változik. Az új generációs keresők már nem csak linkeket adnak, hanem válaszokat: összefoglalják a találatokat, közvetlenül megválaszolják a kérdést, vagy akár különböző forrásokból összesített információt adnak. A mesterséges intelligencia alapú keresési asszisztensek képesek kontextust megérteni: nem csak azt nézik, hogy mit keresel most, hanem emlékeznek a korábbi kérdéseidre és a folytatólagos kérdéseket is értelmezik. Még érdekesebb az a trend, amikor a keresők képessé válnak bizonyos deep webes tartalmak elérésére is: nem teljes indexálással, hanem federated search módszerrel, amikor a keresőmotor valós időben lekérdez különböző adatbázisokat a háttérben. Például ha utazási információkat keresel, a kereső valós időben lekérdezheti a különböző légitársaságok foglalási rendszereit anélkül, hogy ezek a rendszerek nyilvánosan indexelve lennének. Ez egy hibrid modell, amely összeköti a látható és deep web előnyeit. A következő lépés az lehet, hogy teljesen autonóm AI-ügynökök végzik el a keresést helyettünk: nem csak megtalálják az információt, hanem végrehajtják a feladatokat is, mint például foglalás, vásárlás vagy időpontegyeztetés. Ez új magasságokba emeli a kényelmet, de súlyos kérdéseket vet fel a kontroll és a bizalom terén: mennyire bízhatunk meg ezekben az automatikus rendszerekben, és hogyan biztosítjuk, hogy valóban az érdekünkben cselekednek?
Adatvédelem és szabályozási kihívások
Az utóbbi években az adatvédelem kérdése került a középpontba, különösen a nagy technológiai cégek adatgyűjtési gyakorlatainak köszönhetően. A GDPR Európában és hasonló szabályozások más kontinenseken szigorúan korlátozzák, hogy kik, mit és hogyan gyűjthetnek a felhasználókról. Ez különösen érdekes kérdéseket vet fel a deep web esetében, ahol hatalmas mennyiségű személyes adat található. Banki információk, egészségügyi adatok, vásárlási szokások, helyadatok – mindezek rendkívül érzékeny információk, amelyek nem szivároghatnak ki. A szabályozók egyre szigorúbban lépnek fel: adatszivárgás esetén hatalmas bírságokat szabhatnak ki, és az érintettek kártérítési igényekkel élhetnek. A vállalatok számára ez azt jelenti, hogy folyamatosan fejleszteniük kell biztonsági rendszereiket, rendszeresen auditálniuk kell a folyamataikat, és biztosítaniuk kell, hogy az adatkezelési gyakorlataik megfelelnek a jogszabályoknak. A felhasználók számára pedig azt jelenti, hogy egyre több kontrollt kapnak saját adataik felett: joguk van megtudni, ki milyen adatokat tárol róluk, kérhetik ezek törlését, és tiltakozhatnak bizonyos típusú adatkezelések ellen. Az új szabályozások a mesterséges intelligencia területén is megjelennek: egyre több ország vezet be AI-specifikus jogszabályokat, amelyek korlátozzák, hogy milyen célokra használhatók algoritmusok, különösen olyan érzékeny területeken, mint a munkaerő-felvétel, hitelkérelmek elbírálása vagy bűnüldözés. A kihívás az, hogy a technológia gyorsabban fejlődik, mint ahogy a jogalkotók képesek lennének szabályozni, így folyamatosan egy lépéssel lemaradnak.